Хостинг для AI-проектов: какой сервер выбрать для нейросети в 2026 году
В статье рассмотрим, как выбрать сервер для AI, LLM, RAG и нейросетей: CPU, RAM, GPU, VRAM и NVMe. Когда достаточно VPS, а когда нужен GPU-сервер?
Какой сервер нужен для AI-проекта: VPS, GPU-сервер или Dedicated
Разработка и запуск проектов с искусственным интеллектом требуют правильно подобранной серверной инфраструктуры. Однако не каждый такой проект нуждается в мощном оборудовании с графическими процессорами GPU. Во многих случаях для стабильной работы AI-приложения вполне достаточно обычного VPS, а аренда дорогого сервера будет лишней тратой.
Выбор сервера прежде всего зависит от того, как именно ваш проект использует искусственный интеллект. Если приложение работает через API внешних моделей, например, OpenAI, Claude, Gemini или других AI-платформ, основные вычисления выполняются на стороне поставщика услуг. Собственный сервер в такой архитектуре отвечает за работу backend, баз данных, интеграций, RAG-систем, автоматизаций n8n, Telegram-ботов или веб-приложений. Для подобных задач часто хватает стандартного VPS.
Совсем другая ситуация, если вы планируете запускать AI-модели непосредственно на собственном оборудовании. Например, использовать локальные большие языковые модели, генерировать изображения, выполнять Fine-tuning или обучать нейросети. Такие задачи могут требовать значительных вычислительных мощностей, а GPU становится ключевым.
Так какой сервер выбрать для AI-проекта: VPS или GPU-сервер/Dedicated? Чтобы не переплачивать за неиспользуемые ресурсы и при этом обеспечить стабильную работу приложения, нужно отталкиваться от конкретных задач, ожидаемой нагрузки и способа обработки AI-запросов. Рассмотрим, какие ресурсы нужны для разных типов проектов, когда достаточно обычного VPS, а в каких случаях стоит переходить на физический выделенный сервер с GPU.
Что именно будет делать AI-сервер?
Прежде чем выбирать сервер для AI-проекта, нужно определить, какие именно задачи он будет выполнять. Это важный этап, поскольку использование искусственного интеллекта не означает, что обязательно нужно арендовать GPU-сервер с мощной видеокартой. Требования к оборудованию зависят от архитектуры приложения, типа AI-модели и способа обработки данных.
Например, если ваш проект обращается к OpenAI, Claude или Gemini через API, сервер не запускает нейросеть самостоятельно. Он отправляет запросы во внешний сервис, получает ответы и выполняет операции. Для такой архитектуры обычно достаточно VPS с соответствующими ресурсами CPU, RAM и быстрым сетевым соединением.
Но бывают случаи, когда AI-модель нужно разместить на собственном сервере, например, для локального запуска LLM, генерации изображений или обучения нейросети. В таком случае важными становятся графический процессор (GPU) и объём его видеопамяти (VRAM), ведь именно они обеспечивают необходимую вычислительную производительность.
Поэтому рассмотрим самые распространённые задачи AI-проектов и основные требования к серверным ресурсам в таблице:
|
Задача AI-проекта |
Нужен ли GPU |
Основные ресурсы |
|
OpenAI/Claude/Gemini API |
Нет |
CPU, RAM, сеть |
|
Telegram-бот или Discord-бот с AI |
Обычно нет |
CPU, RAM |
|
n8n+AI-автоматизация |
Обычно нет |
RAM, CPU |
|
RAG с внешним AI API |
Обычно нет |
RAM, NVMe, база данных |
|
Vector Database |
Нет, зависит от масштаба |
RAM, NVMe, CPU |
|
Запуск небольшой локальной LLM |
Да, желательно |
GPU, VRAM |
|
Production LLM Inference |
Да |
GPU, VRAM |
|
Генерация изображений |
Да |
GPU, VRAM |
|
Fine-tuning модели |
Да |
GPU, VRAM, RAM |
|
Обучение модели с нуля |
Да |
GPU, специализированная инфраструктура |
Обратим внимание, что данная таблица показывает типичные требования, а не универсальные минимальные конфигурации. Реальные потребности зависят от размера модели, количества одновременных запросов, объёма данных и выбранного ПО.
Чем отличаются основные типы AI-нагрузки?
-Работа с внешними AI API. Это один из самых распространённых сценариев использования искусственного интеллекта. Приложение взаимодействует с готовыми моделями через API, а вычисления происходят на инфраструктуре провайдера. К этой категории относятся AI-чатботы на базе OpenAI, Claude или Gemini; Telegram- и Discord-боты с генерацией ответов; автоматизация бизнес-процессов через n8n; веб-приложения с AI-функциями; RAG-системы, использующие внешнюю языковую модель.
-Работа с базами данных и RAG. Если AI-проект должен искать информацию в собственной базе документов, отвечать на вопросы по внутренним материалам или находить нужный контент по смыслу, понадобится RAG.
-Если генерация ответов выполняется через внешний AI API, GPU обычно не нужен. Зато важными становятся RAM, NVMe SSD, CPU, объём дискового пространства.
-Локальный запуск AI-моделей. Сервер самостоятельно выполняет вычисления, необходимые для генерации ответов. Основной параметр при выборе оборудования - VRAM, то есть объём видеопамяти GPU.
-Генерация изображений и обучение моделей. Эти задачи относятся к более ресурсоёмким сценариям использования AI. В таких случаях GPU становится обязательным компонентом инфраструктуры.
Итак, перед арендой сервера нужно определить конкретный тип нагрузки. Если модель работает через внешний API, чаще всего можно начать с обычного VPS. Если же вычисления выполняются локально, стоит рассматривать GPU-сервер.
Рисунок 1. API или собственная модель: какой сервер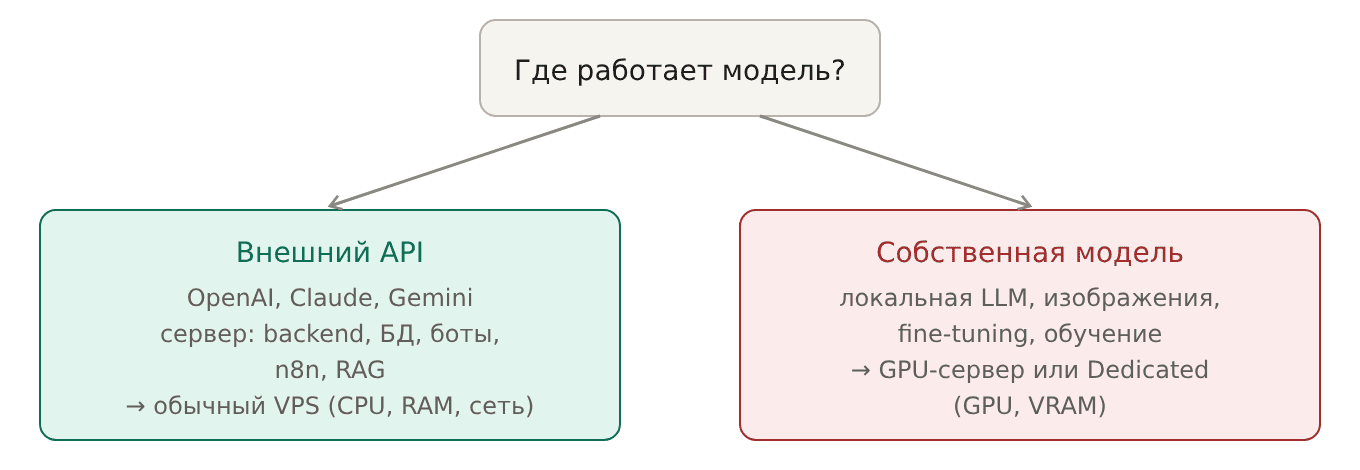
Когда для AI достаточно обычного VPS?
Обычный VPS может стать оптимальным решением для многих AI-проектов, если они используют внешние языковые модели через API.
В каких случаях для AI-проекта хватит VPS?
⮕Сайт с подключённым OpenAI API. Веб-приложение использует языковую модель для генерации текстов, ответов на вопросы, анализа информации или работы AI-помощника. VPS обеспечивает работу сайта, backend и обработку запросов.
⮕Telegram-бот через Claude API. Бот принимает сообщения пользователей, передаёт их в Claude, получает сгенерированные ответы и отправляет их обратно. Для этого обычно достаточно ресурсов обычного VPS.
⮕CRM с интеграцией Gemini. Система использует модель для анализа обращений клиентов, автоматизации ответов, классификации заявок или подготовки отчётов. Сервер обслуживает CRM, базу данных и интеграции.
⮕n8n с AI-автоматизацией. Платформа запускает workflow, передаёт информацию между сервисами, обращается к AI API и выполняет автоматизированные операции. В этом случае важными являются процессор и ОЗУ.
⮕SaaS с внешней LLM. Программный продукт использует OpenAI, Claude, Gemini или другую модель для предоставления AI-функций своим пользователям. VPS размещает серверную часть SaaS, базы данных, API и другие компоненты системы.
Что размещается на VPS для AI-проекта?
При использовании внешних AI-моделей сервер выполняет функции основной инфраструктуры приложения. В зависимости от архитектуры проекта на нём могут работать backend, API, web application, database, Redis, queue, n8n, bot, authentication, logs, files. Не каждому проекту нужны все перечисленные компоненты.
Какую конфигурацию VPS выбрать для AI-проекта?
При выборе VPS важно учитывать не только сам факт интеграции с искусственным интеллектом, но и количество пользователей, интенсивность запросов, backend и количество одновременно запущенных процессов.
Для ориентира можно использовать следующие стартовые конфигурации:
|
Тип проекта |
Стартовая конфигурация VPS |
|
Простой AI-бот или API proxy |
2 vCPU/4 GB RAM |
|
AI SaaS, n8n или небольшой backend |
4 vCPU/8 GB RAM |
|
RAG + база данных + backend |
4-8 vCPU/8-16 GB RAM |
|
Много одновременных пользователей |
От 8 vCPU/16 GB RAM |
Если AI-проект использует внешние модели через API, обычный VPS часто обеспечивает все необходимые ресурсы для его работы. Начинать можно с небольшой конфигурации, а по мере роста количества пользователей и нагрузки увеличивать CPU, RAM и дисковое пространство.
Какой тариф в ГиперХост выбрать?
Обязательно ориентируйтесь на количество пользователей, интенсивность запросов и количество процессов, работающих одновременно. В таблице только стартовые варианты из актуальной линейки VPS и VDS ГиперХост (цены за месяц при помесячной оплате; при оплате на 2 года тарифы дешевле).
|
Тип |
Что нужно |
Тарифы |
|
Простой AI-бот, API-прокси |
1-2 vCPU, 1-2 GB RAM |
VPS Мини (1 vCPU/1 GB) от $3,84; VPS Доступный (2 vCPU/1,5 GB) от $7,56 |
|
n8n с AI, небольшой backend |
2-3 vCPU, 2-4 GB RAM |
VPS Старт (2 vCPU/3 GB) от $13,60; VDS Старт (2 vCPU/2 GB) от $21,02 |
|
AI SaaS с базой данных |
3-4 vCPU, 4-7 GB RAM |
VPS Мега-хост (3 vCPU/5 GB) от $25,10; VPS Ультра (4 vCPU/7 GB) от $37,17 |
|
RAG + база + backend, много пользователей |
4+ vCPU, 8-10 GB RAM |
VPS Ультра+ (4 vCPU/10 GB) от $62,69; VDS Ультра+ (4 vCPU/10 GB) от $89,55 |
|
Более 10 GB RAM |
16-64 GB RAM и более |
Выделенный сервер |
В линейке ГиперХост есть VPS и VDS (KVM). Если вы собираетесь разворачивать проект в Docker, удобнее брать KVM-вариант: полная виртуализация меньше ограничивает работу с контейнерами. Для обычного бота или сайта без контейнеров подойдёт и VPS, который стоит дешевле.
Когда AI-проекту нужен GPU
GPU-сервер нужен в тех случаях, когда AI-проект должен самостоятельно выполнять вычисления нейросети. GPU нужен не потому, что проект называется AI, а потому, что именно сервер выполняет нейросетевые вычисления. Если модель размещена на собственной инфраструктуре, сервер должен иметь достаточную вычислительную мощность и видеопамять для её работы.
Когда GPU обязателен:
-Запуск LLM локально. Если нужно развернуть собственную большую языковую модель на сервере, например, для создания AI-ассистента, чатбота или внутренней системы обработки информации.
-Конфиденциальность данных и независимость от внешних API.
-Если AI-система должна самостоятельно обрабатывать запросы пользователей с помощью локально размещённой модели, GPU обеспечивает необходимые вычислительные ресурсы.
-Генерация изображений. GPU с достаточным объёмом VRAM позволяет запускать такие модели и сокращать время создания изображений.
-Если нужно адаптировать уже обученную нейросеть под специфические задачи, отраслевую терминологию или собственные данные, понадобится GPU.
-Обучение собственных нейросетей. Для больших моделей может понадобиться несколько графических процессоров.
-Если AI-сервис должен одновременно обслуживать много пользователей, а все запросы обрабатываются собственной моделью, важными становятся производительность GPU и объём VRAM.
Почему для AI важна видеопамять VRAM? Один из главных параметров - объём VRAM (Video Random Access Memory), то есть памяти графического процессора. В ней размещаются веса нейросети, промежуточные данные и другие компоненты, необходимые для выполнения вычислений. Если видеопамяти недостаточно, часть вычислений придётся переносить в системную RAM или использовать другие способы распределения нагрузки.
Для таких задач сервер подбирается индивидуально в ГиперХост под требования клиента: напишите нам модель, которую планируете запускать, и мы рассчитаем конфигурацию и сроки.
Что важнее для AI: RAM или VRAM?
При выборе сервера для AI-проекта важно учитывать не только количество процессорных ядер и производительность оборудования, но и объём памяти. В частности, нужно различать RAM (оперативную память сервера) и VRAM (видеопамять графического процессора). Оба параметра влияют на работу AI-системы, но выполняют разные функции.
Если проект использует внешние AI API, основную нагрузку на память создают backend, базы данных, кэширование и другие компоненты приложения. В таком случае достаточно правильно подобрать объём обычной RAM. Если же модель запускается непосредственно на собственном GPU-сервере, критическим параметром становится VRAM. Даже если AI-модель работает на GPU, серверу всё равно нужен достаточный объём обычной оперативной памяти для поддержания всей инфраструктуры.
Сколько VRAM нужно для LLM?
Если планируете запускать большую языковую модель на собственном GPU-сервере, одним из главных критериев выбора будет объём видеопамяти. Потребность в VRAM зависит от размера модели, формата данных, длины контекста и количества одновременных запросов. Фактические требования зависят от модели, precision, quantization, context length и concurrency.
|
Использование |
Ориентировочный объём VRAM |
|
Небольшие quantized models |
Приблизительно 6-16 GB в зависимости от модели |
|
7-8B production inference |
Около 24 GB с запасом |
|
13B production inference |
Около 48 GB с запасом |
|
Большие модели класса 70B |
Несколько GPU или сильная квантизация и offloading |
При выборе GPU-сервера учитывайте не только количество параметров LLM, но и ожидаемую нагрузку.
Почему quantization изменяет требования к серверу
Квантизация – это способ уменьшить объем памяти, необходимый для хранения весов AI-модели. Для этого используют менее точные числовые форматы. Благодаря этому модель может поместиться на GPU с меньшим объемом VRAM, а иногда работать на более доступном оборудовании.
Например, модель из 7 млрд параметров в формате FP16 или BF16 требует примерно 14 GB памяти только для хранения весов. При 8-bit quantization этот показатель может снизиться примерно до 7 GB, а при 4-bit до 3,5 GB без учета дополнительных затрат. Однако это не означает, что для запуска такой модели достаточно GPU с соответствующим объемом VRAM. Кроме весов, видеопамять необходима для KV cache, временных буферов, работы среды выполнения и обработки запросов.
Рисунок 2. Квантование: память для весов модели 7B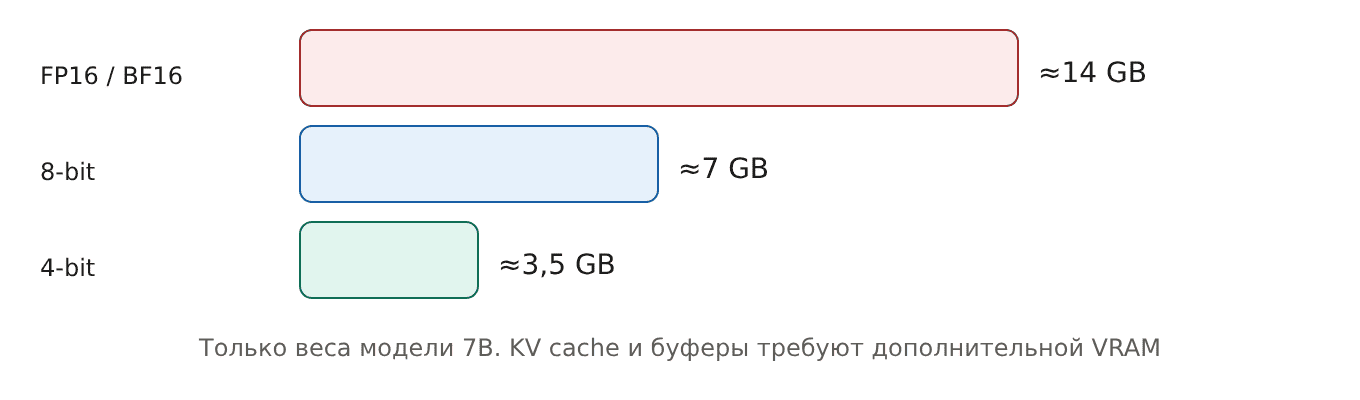
Context length и concurrency: почему модель вдруг перестает умещаться? Во время работы сервера LLM необходимо хранить не только весы модели, но и информацию о предыдущих токенах в пределах текущего запроса. Для этого используется KV cache.
На объем KV cache влияют два важных параметра: Context length – длина контекста, который модель может обработать; Concurrency – количество запросов, которые сервер обрабатывает одновременно. Например, запуск одной LLM для одного пользователя с контекстом 4K и обслуживания 50 одновременных пользователей с контекстом 32K или 128K – это принципиально разные сценарии с точки зрения использования памяти. В обоих случаях используется та же модель, но во второй нагрузке на GPU может быть значительно выше.
Поэтому при выборе GPU-сервера недостаточно проверить, помещаются ли весы модели в VRAM. Следует также учесть максимальную длину контекста, ожидаемое количество одновременных запросов и настройки batching. Если эти параметры не учтены, модель может успешно запускаться во время тестирования, но не будет хватать видеопамяти под реальной нагрузкой.
Рисунок 3. Что занимает видеопамять (VRAM)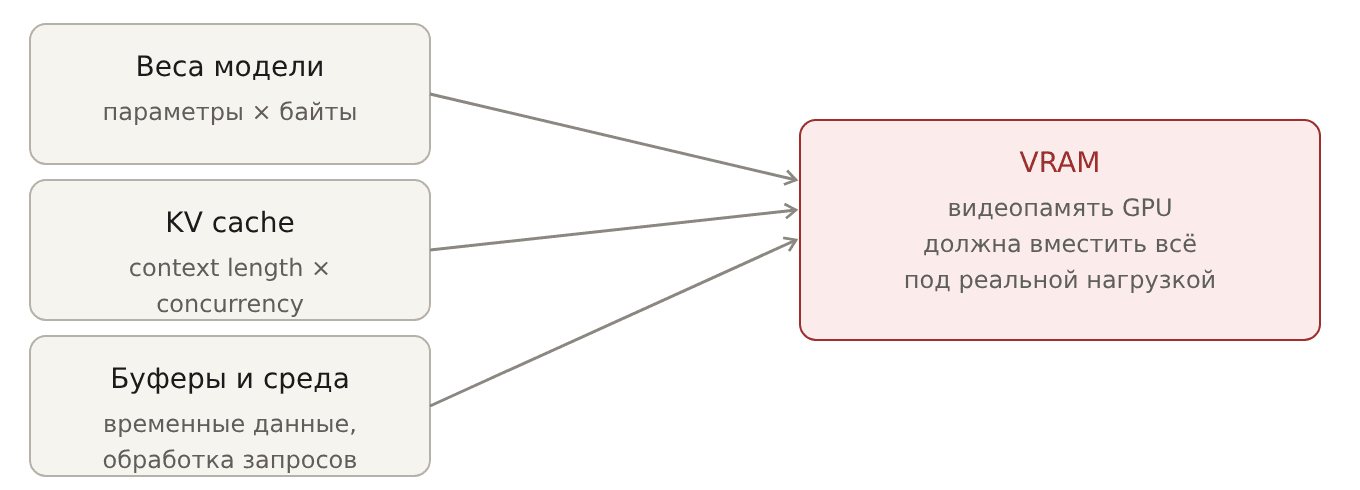
Сколько RAM нужно AI-серверу?
Объём оперативной памяти для AI-сервера зависит от типа проекта, количества одновременных процессов и объёма данных, которые нужно обрабатывать. Если приложение использует внешние AI API, основную нагрузку создают backend, базы данных и другие компоненты системы. Если же на сервере запускается собственная нейросеть, RAM дополнительно нужна для загрузки модели, обработки данных и поддержания работы операционной системы. Для разных AI-задач можно ориентироваться на следующие значения:
|
Тип AI-проекта |
Ориентировочный объём RAM |
|
Небольшое AI-приложение через API |
4-8 GB |
|
RAG + база данных |
8-32+ GB |
|
Локальный запуск LLM |
Зависит от модели и использования CPU offloading |
|
Обучение нейросетей |
От 32 GB и более в зависимости от задачи |
Для обучения нейросетей требования к RAM обычно выше, поскольку сервер должен одновременно обрабатывать обучающие данные, поддерживать работу модели и хранить промежуточные результаты.
Какой CPU нужен для AI?
Процессор остаётся важным компонентом AI-сервера даже тогда, когда основные вычисления нейросети выполняет GPU. Он отвечает за работу ОС, обработку запросов, взаимодействие между компонентами приложения и подготовку данных для модели.
В зависимости от архитектуры AI-проекта процессор может выполнять API и backend, preprocessing (подготовка текстов, изображений и других данных перед передачей модели), tokenization (преобразование текста в токены для дальнейшей обработки языковой моделью), обработку запросов к базам данных, выполнение основных функций веб-приложения, SaaS или чатбота, обработку документов, загрузку и сохранение файлов, управление очередями задач, автоматизациями и распределением нагрузки между сервисами.
Особенно важным CPU становится для проектов, использующих внешние AI API. Если AI-модель работает на GPU, процессор помогает подготовить данные, обработать запросы и передать задание графическому процессору.
На что обратить внимание при выборе CPU? Не стоит руководствоваться только количеством ядер по принципу «чем больше, тем лучше». Необходимая производительность зависит от типа приложения, количества одновременных пользователей, сложности обработки данных и количества запущенных сервисов.
Почему для AI желателен NVMe?
При выборе сервера для AI-проекта важно учитывать не только процессор, оперативную и видеопамять, но и тип накопителя. Для таких задач желательно использовать NVMe SSD, поскольку он обеспечивает высокую скорость чтения и записи данных. Это особенно важно для проектов, которые работают с большими файлами, базами данных, нейросетями и наборами обучающих данных. Высокая скорость накопителя имеет наибольшее значение для AI-проектов, которые часто работают с большими объёмами информации.
VPS или Dedicated Server для AI?
При выборе серверной инфраструктуры для AI-проекта часто возникает вопрос: что лучше - VPS или Dedicated Server? Оба варианта могут использоваться для размещения AI-приложений, но отличаются способом выделения ресурсов, возможностями масштабирования и стоимостью аренды.
VPS - это виртуальный сервер с выделенными ресурсами на физическом оборудовании. Он подходит для большинства небольших и средних AI-проектов.
Dedicated Server - это физический сервер, ресурсы которого полностью доступны одному пользователю. Такой вариант лучше для проектов с высокой нагрузкой, локальным запуском больших моделей, обучением нейросетей или специфическими требованиями к оборудованию.
Сравнение VPS и Dedicated-сервера для AI
Чтобы определить, какой вариант лучше отвечает потребностям проекта, сравним их по основным вариантам использования в следующей таблице:
|
|
VPS |
Выделенный сервер |
|
AI через внешние API |
Да |
Обычно не нужен |
|
n8n + AI-автоматизация |
Да |
Обычно не нужен |
|
RAG-системы |
Да |
Целесообразен при большой нагрузке |
|
Local CPU inference |
Возможно, зависит от ресурсов |
Да, при соответствующей конфигурации |
|
GPU inference |
Только если VPS имеет GPU |
Да, если выбрать GPU-сервер |
|
Обучение моделей |
Редко подходит |
Для соответствующих конфигураций |
|
Root доступ |
Да |
Да |
|
Масштабирование |
Обычно проще |
Требует замены оборудования |
|
Начальная стоимость |
Ниже |
Выше |
Когда стоит выбрать VPS?
VPS будет практичным решением, если AI-проект использует внешние API, не требует собственных GPU-вычислений и не создаёт чрезмерной нагрузки на сервер. Главное преимущество VPS - возможность начать с относительно небольшой конфигурации и постепенно увеличивать ресурсы в соответствии с ростом нагрузки.
Когда лучше выбрать выделенный сервер?
Физический сервер целесообразен, когда проекту нужны значительные вычислительные ресурсы, стабильная производительность под постоянной нагрузкой или специализированная конфигурация сервера. Отдельное преимущество - возможность использовать ресурсы физического оборудования без разделения с другими VPS. Это может быть важно для проектов с постоянной высокой нагрузкой или специфическими требованиями к процессору, оперативной памяти, накопителям и GPU.
Что выбрать для AI-проекта?
Если вы разрабатываете AI-бота, SaaS, веб-приложение или автоматизацию на базе внешних моделей, начинайте с обычного VPS. Dedicated имеет смысл тогда, когда реальная нагрузка, потребность в локальных вычислениях или требования к оборудованию оправдывают его стоимость. Не стоит арендовать физический сервер только потому, что ваш проект использует искусственный интеллект. Сначала стоит определить необходимые ресурсы, протестировать нагрузку и лишь при необходимости переходить на более мощную инфраструктуру.
Linux или Windows для AI-сервера?
При аренде сервера для AI-проекта нужно определиться не только с аппаратными характеристиками, но и с ОС. Чаще всего для таких задач используют Linux ВПС, поскольку он хорошо подходит для работы с Python, Docker, фреймворками машинного обучения и инструментами развёртывания AI-моделей. Для AI-серверов чаще всего выбирают Ubuntu Server или Debian.
Вместе с тем Windows ВДС также может быть полноценным вариантом, если этого требует программное обеспечение. Эта операционная система поддерживает инструменты разработки, Python, Docker и работу с GPU. Её выбор может быть оправданным, если проект зависит от конкретного ПО или сервисов экосистемы Microsoft.
Примеры конфигураций AI-сервера
Выбор конфигурации AI-сервера зависит от того, какие задачи будет выполнять проект и где именно будут происходить вычисления: на внешнем сервисе или непосредственно на сервере. Для приложений, использующих API OpenAI или Claude, обычно достаточно VPS с CPU и RAM. Если же нужно запускать собственную языковую модель, генерировать изображения или обучать нейросеть, понадобятся более мощные ресурсы и GPU. Примеры стартовых конфигураций в этой таблице:
|
Пример проекта |
CPU |
RAM |
GPU |
|
AI Telegram bot через API |
2 vCPU |
4 GB |
Не нужен |
|
n8n + OpenAI/Claude |
4 vCPU |
8 GB |
Не нужен |
|
AI web app + PostgreSQL |
4 vCPU |
8-16 GB |
Не нужен |
|
RAG + vector DB |
4-8 vCPU |
16-32 GB |
Необязательно |
|
Local small LLM |
4-8+ CPU |
16-32+ GB |
Желательно 8-24+ GB VRAM |
|
7–8B production LLM |
8+ CPU |
32+ GB |
Ориентир 24 GB VRAM |
|
13B production LLM |
8-16+ CPU |
32-64+ GB |
Ориентир 48 GB VRAM |
|
Training/fine-tuning |
Зависит от задачи |
64+ GB |
GPU / multi-GPU |
Перед заказом сервера стоит проверить требования конкретной модели и оценить ожидаемую нагрузку (особенно это важно для GPU-серверов).
Как выбрать сервер для AI: чек-лист
Перед заказом сервера для AI-проекта важно оценить не только текущие потребности, но и возможный рост нагрузки. Это поможет подобрать конфигурацию без лишних затрат и избежать нехватки ресурсов во время работы.
Где будет запускаться модель? Определите, непосредственно на сервере или через внешний API.
Какая именно модель будет использоваться? Определите её название и технические требования.
Сколько параметров у модели? Например, 7B, 13B или больше.
Какие precision и quantization нужны? FP16, BF16, INT8 или INT4 влияют на потребление памяти и производительность.
Какая длина контекста? Чем больше контекст, тем больше памяти может понадобиться.
Сколько пользователей будут работать одновременно? От этого зависит необходимая производительность сервера.
Что планируется выполнять: inference или training? Запуск готовой модели и её обучение имеют разные требования к оборудованию.
Нужна ли векторная база данных? Учтите её требования к RAM, CPU и дисковому пространству.
Какой объём данных нужно хранить? Оцените размер документов, моделей, индексов, резервных копий и журналов.
Нужен ли GPU? Если модель будет работать через внешний API, отдельная видеокарта обычно не нужна.
Какой объём VRAM необходим? Проверьте, хватит ли видеопамяти для модели, контекста и одновременных запросов.
Какой ожидается трафик? Оцените количество запросов и пиковую нагрузку.
Нужно ли масштабирование? Продумайте, как увеличить CPU, RAM, хранилище или GPU-ресурсы по мере роста проекта.
Как не переплачивать за AI-сервер?
При выборе сервера стоит отталкиваться от реальных задач проекта, а не только от того, что он использует искусственный интеллект. Не каждое AI-приложение требует мощного оборудования.
Если количество пользователей и запросов растёт, можно делать это постепенно.
Есть несколько практических способов сэкономить при аренде сервера в ГиперХост:
✓воспользуйтесь тестовым периодом, чтобы измерить реальное потребление RAM и CPU;
✓ если проект долгосрочный, рассмотрите оплату на 2 года: тарифы VPS и VDS при этом дешевле (например, VPS Старт стоит $10,34 вместо $13,60 в месяц);
✓не берите GPU, пока модель у вас не работает;
✓закладывайте архитектуру, которую можно масштабировать без полной перестройки.
Какой сервер нужен для вашего AI-проекта?
При выборе сервера для AI важно учитывать не только количество ядер CPU и объём RAM. Если планируете запускать локальные LLM, нужно также оценить размер модели, объём VRAM, тип quantization, длину контекста и количество одновременных запросов.
Чтобы подобрать оптимальную конфигурацию, сообщите нашим техническим специалистам подробную информацию: какую AI-модель планируете использовать; будет ли проект работать через внешний API или модель будет запускаться локально; сколько пользователей ожидается одновременно и какой объём данных нужно хранить/обрабатывать.
Специалисты HyperHost помогут оценить требования и подобрать подходящий сервер, например, VPS для AI-приложений или мощную инфраструктуру для локальных моделей. В ГиперХост вы сможете получить необходимые ресурсы без переплаты за мощности, которые сейчас не нужны.
FAQ
Какой сервер нужен для AI-проекта? Зависит от того, где работает модель. Если через внешний API (OpenAI, Claude, Gemini), обычно хватает VPS с нужными CPU и RAM. Если модель запускается на собственном сервере, нужен GPU-сервер.
Когда для AI достаточно обычного VPS? Для сайтов с подключённым API, Telegram-ботов, CRM с интеграцией ИИ, n8n-автоматизаций и SaaS на внешней LLM. VPS размещает backend, базы данных, интеграции.
Когда AI-проекту нужен GPU? Для локального запуска LLM, генерации изображений, fine-tuning, обучения нейросетей, а также когда нужны конфиденциальность данных и независимость от внешних API.
Чем VRAM отличается от RAM? RAM — оперативная память сервера, VRAM — память графического процессора. В VRAM размещаются веса нейросети и промежуточные данные. Увеличение RAM не заменит нехватку VRAM для комфортного запуска LLM на GPU.
Сколько VRAM нужно для LLM? Ориентиры из статьи: небольшие quantized-модели приблизительно 6–16 GB, 7–8B для production около 24 GB с запасом, 13B около 48 GB, большие модели класса 70B требуют нескольких GPU или сильной квантизации и offloading.
Что такое квантизация? Это способ уменьшить память для хранения весов модели менее точными числовыми форматами. Модель на 7 млрд параметров в FP16 требует около 14 GB, в 8-bit около 7 GB, в 4-bit около 3,5 GB, но это только веса.
Почему модель может перестать умещаться в VRAM? Кроме весов, нужна память для KV cache, который растёт с длиной контекста и количеством одновременных запросов. Поэтому нужно учитывать context length, concurrency и batching.
VPS или Dedicated Server для AI? VPS подходит для большинства небольших и средних проектов и даёт более низкую начальную стоимость. Dedicated лучше для высоких нагрузок, локального запуска больших моделей и обучения нейросетей.
Linux или Windows для AI-сервера? Чаще всего выбирают Linux VPS (Ubuntu Server или Debian) для Python, Docker и ML-фреймворков. Windows VDS подойдёт, если этого требует ПО или сервисы экосистемы Microsoft.
Как не переплачивать за AI-сервер? Начинайте с необходимого минимума, воспользуйтесь тестовым периодом, рассмотрите оплату на 2 года, не берите GPU, пока модель у вас не работает, и закладывайте архитектуру, которую можно масштабировать. Рассмотрите VPS и VDS и выделенные серверы.

.png)